逻辑时钟:Lamport 与向量
在分布式系统里没有全局时钟,事件的先后顺序只能靠别的方式定义。本篇走完整条线:先用偏序与全序这两个数学概念划清"顺序"到底指什么,再看 Lamport 1978 年的标量逻辑时钟能做什么、做不到什么,最后看向量时钟如何补上那个缺口 —— 并在 Dynamo 的版本向量里落到工程。
在分布式系统中,由于有多个机器(进程)在一起协调工作,于是如何定义分布式系统中事件的先后顺序就成了难题,本篇展开的是 Lamport 1978 年的 Time, Clocks, and the Ordering of Events in a Distributed System 里的推导(题录见文末「参考」)。

什么是逻辑时钟
逻辑时钟是为了解决分布式系统中事件顺序问题而提出的概念。与物理时钟不同,逻辑时钟不依赖于实际时间,而是通过节点间的交互来确定事件的先后顺序。
分布式系统中定义一个事件的先后顺序是一个难点,下意识的第一反应是:给每个事件加上一个物理的时间戳,不就可以比较不同事件的时间戳来决定其顺序了吗?
这样做的问题在于:在分布式系统中,由多个机器组合起来协调工作,而每个机器上的物理时间也不尽相同,所以“物理时间戳”本质上是一个机器属性,并不一定系统中所有机器都满足同一个时间度量。
在分布式系统中,事件的顺序难以直接通过物理时间戳确定,因为不同机器的物理时间可能不一致,而且如果两个节点不交互,它们的时间无需同步。逻辑时钟通过节点间的交互,确保事件顺序的一致性,而不依赖于物理时间。它关注的是事件的因果关系,而非实际时间。物理时间戳的局限性在于它依赖于本地机器时间,不同机器的时间可能不一致,因此在分布式系统中,物理时间戳无法全局一致地衡量事件顺序。逻辑时钟的核心在于通过节点交互确定事件顺序,而非依赖物理时间。它解决了分布式系统中事件顺序的难题,避免了物理时钟不同步带来的问题。
时序关系与相对论
通过前面的讨论我们知道通过物理时钟(即绝对参考系)来区分先后顺序的前提是所有节点的时钟完全同步,但目前并不现实。因此,在没有绝对参考系的情况下,在一个分布式系统中,你无法判断事件A是否发生在事件B之前,除非A和B存在某种依赖关系,即分布式系统中的事件仅仅是部分有序的。
上面的结论跟狭义相对论有异曲同工之妙,在狭义相对论中,不同观察者在同一参考系中观察到的事件先后顺序是一致的,但是在不同的观察者在不同的参考系中对两个事件谁先发生可能具有不同的看法. 当且仅当事件A是由事件B引起的时候, 事件A和B之间才存在一个先后关系。**两个事件可以建立因果关系的前提是:两个事件之间可以用等于或小于光速的速度传递信息。**这里的因果关系指的是时序关系,即时间的前后,并不是逻辑上的原因和结果。
那么是否我们可以参考狭义相对论来定义分布式系统中两个事件的时序呢?在分布式系统中,网络是不可靠的,所以我们去掉可以和速度的约束,可以得到两个事件可以建立因果(时序)关系的前提是:两个事件之间是否发生过信息传递。在分布式系统中,进程间通信、消息发送等都属于信息传递,如果两个进程间没有任何交互,实际上他们之间内部事件的时序也无关紧要。但是有交互的情况下,特别是多个节点的要保持同一副本的情况下,事件的时序非常重要。
happen-before关系
一个分布式系统中的事件,在很多情况(只是很多情况下,并没有全部,下面会展开讨论)下都能定义其先后顺序了,Lamport 把这个关系定义为happen-before关系:
- 引入符号 → 做为表示事件之间
happen-before的记号。 - 在同一个进程中,如果事件a在事件b之前发生,那么a→b。(这是因为根据规则1,进程每次发出事件之后都会将本地的lamport时钟加一,于是可以在同一个进程内定义事件的先后顺序了)
- 在不同的进程中,如果事件a表示一个进程发出一个事件,事件b表示接收进程收到这个事件,那么也必然满足a→b。(这是因为根据规则2,接收进程在收到事件之后会取本地时钟和事件时钟的最大值并且+1,于是发出事件和接收事件尽管在不同的进程,但是也可以比较其lamport时钟知道其先后顺序了)
- 最后,
happend-before关系是满足传递性的,即:如果a→b且b→c,那么也一定有a→c。
讲到了这里,似乎已经明白了lamport时钟要解决的问题,以及分布式系统中事件之间happend-before关系的定义。但是还有疑点没有解开:
- 一个分布式系统中的事件是否都满足
happen-before关系?按照前面全序、偏序关系的定义,这个问题相当于问:happen-before关系是全序还是偏序关系?(全序、偏序)
这两个问题可以放在一起解答:分布式系统中的所有事件并不都满足happen-before关系,按照前面全序、偏序关系的定义,由于这个集合中并不是所有情况下都满足这种关系,所以说happen-before关系是一种偏序关系。
以下图来看看:
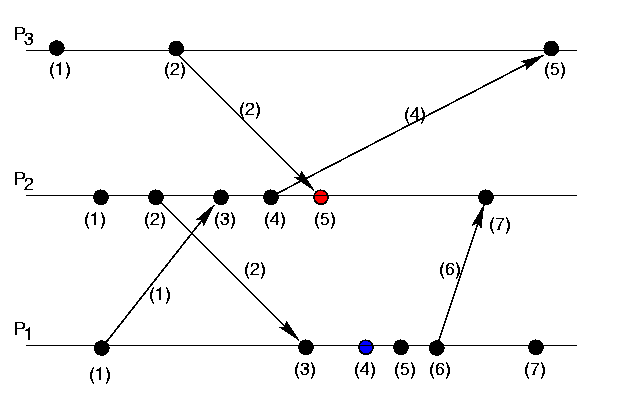
(引用自Lamport Clocks - Kevin Sookocheff)
这个系统的工作方式,在前面解释规则1、2的时候已经有说明,在这里就不再阐述。可以注意到P3进程和P2进程都有一个时间2,在这个时间上这两个进程做了两个不同的事件:
- 从进程P3的视角来看:时间2发出事件给进程P2,按照算法最后进程P2计算出来收到这个事件的时间为5。
- 从进程P2的视角来看,在本进程上时间2也在时间5之前。
所以无论如何,这两个进程上在时间2上发生的事件都不能比较先后顺序了。
如果分布式系统中的两个事件,不满足happen-before关系,称这两个事件为“并行事件(concurrent event)”。
现实的系统中,确实存在很多并行事件。比如向一个KV系统中同时写入两个并无关联的数据,由于无法根据Lamport时钟对比出先后来,这些操作就可以认为是并行的。
Lamport 逻辑时钟
分布式系统中按是否存在节点交互可分为三类事件,一类发生于节点内部,二是发送事件,三是接收事件。注意:以下文章中提及的时间戳如无特别说明,都指的是Lamport 逻辑时钟的时间戳,不是物理时钟的时间戳
逻辑时钟定义 Clock Condition.对于任意事件a, b:如果a -> b(->表示a先于b发生),那么C(a) < C(b), 反之不然, 因为有可能是并发事件 C1.如果a和b都是进程Pi里的事件,并且a在b之前,那么Ci(a) < Ci(b) C2.如果a是进程Pi里关于某消息的发送事件,b是另一进程Pj里关于该消息的接收事件,那么Ci(a) < Cj(b)
Lamport 逻辑时钟原理如下:

- 每个事件对应一个Lamport时间戳,初始值为0
- 如果事件在节点内发生,本地进程中的时间戳加1
- 如果事件属于发送事件,本地进程中的时间戳加1并在消息中带上该时间戳
- 如果事件属于接收事件,本地进程中的时间戳 = Max(本地时间戳,消息中的时间戳) + 1
假设有事件a、b,C(a)、C(b)分别表示事件a、b对应的Lamport时间戳,如果a发生在b之前(happened before),记作 a -> b,则有C(a) < C(b),例如图1中有 C1 -> B1,那么 C(C1) < C(B1)。通过该定义,事件集中Lamport时间戳不等的事件可进行比较,我们获得事件的偏序关系(partial order)。注意:如果C(a) < C(b),并不能说明a -> b,也就是说C(a) < C(b)是a -> b的必要不充分条件
如果C(a) = C(b),那a、b事件的顺序又是怎样的?当C(a) = C(b)的时候,它们肯定不是因果关系,所以它们之间的先后其实并不会影响结果,我们这里只需要给出一种确定的方式来定义它们之间的先后就能得到全序关系。注意:Lamport逻辑时钟只保证因果关系(偏序)的正确性,不保证绝对时序的正确性。
一种可行的方式是利用给进程编号,利用进程编号的大小来排序。假设a、b分别在节点P、Q上发生,Pi、Qj分别表示我们给P、Q的编号,如果 C(a) = C(b) 并且 Pi < Qj,同样定义为a发生在b之前,记作 a => b(全序关系)。假如我们对图1的A、B、C分别编号Ai = 1、Bj = 2、Ck = 3,因 C(B4) = C(C3) 并且 Bj < Ck,则 B4 => C3。
通过以上定义,我们可以对所有事件排序,获得事件的全序关系(total order)。上图例子,我们可以进行排序:C1 => B1 => B2 => A1 => B3 => A2 => C2 => B4 => C3 => A3 => B5 => C4 => C5 => A4
观察上面的全序关系你可以发现,从时间轴来看B5是早于A3发生的,但是在全序关系里面我们根据上面的定义给出的却是A3早于B5,可以发现Lamport逻辑时钟是一个正确的算法,即有因果关系的事件时序不会错,但并不是一个公平的算法,即没有因果关系的事件时序不一定符合实际情况。
如何使用逻辑时钟解决分布式锁问题
上面的分析过于理论,下面我们来尝试使用逻辑时钟来解决分布式锁问题。
分布式锁问题本质上是对于共享资源的抢占问题,我们先对问题进行定义:
- 已经获得资源授权的进程,必须在资源分配给其他进程之前释放掉它;
- 资源请求必须按照请求发生的顺序进行授权;
- 在获得资源授权的所有进程最终释放资源后,所有的资源请求必须都已经被授权了。
首先我们假设,**对于任意的两个进程Pi和Pj,它们之间传递的消息是按照发送顺序被接收到的, 并且所有的消息最终都会被接收到。每个进程会维护一个它自己的对其他所有进程都不可见的请求队列。我们假设该请求队列初始时刻只有一个消息(T0:P0)资源请求,P0代表初始时刻获得资源授权的那个进程,T0小于任意时钟初始值
- 为请求该项资源,进程Pi发送一个(Tm:Pi)资源请求(请求锁)消息给其他所有进程,并将该消息放入自己的请求队列,在这里Tm代表了消息的时间戳
- 当进程Pj收到(Tm:Pi)资源请求消息后,将它放到自己的请求队列中,并发送一个带时间戳的确认消息给Pi。(注:如果Pj已经发送了一个时间戳大于Tm的消息,那就可以不发送)
- 释放该项资源(释放锁)时,进程Pi从自己的消息队列中删除所有的(Tm:Pi)资源请求,同时给其他所有进程发送一个带有时间戳的Pi资源释放消息
- 当进程Pj收到Pi资源释放消息后,它就从自己的消息队列中删除所有的(Tm:Pi)资源请求
- 当同时满足如下两个条件时,就将资源分配(锁占用)给进程Pi:
- 按照全序关系排序后,(Tm:Pi)资源请求排在它的请求队列的最前面
- i已经从所有其他进程都收到了时间戳>Tm的消息
下面我会用图例来说明上面算法运作的过程,假设我们有3个进程,根据算法说明,初始化状态各个进程队列里面都是(0:0)状态,此时锁属于P0。

接下来P1会发出请求资源的消息给所有其他进程,并且放到自己的请求队列里面,根据逻辑时钟算法,P1的时钟走到1,而接受消息的P0和P2的时钟为消息时间戳+1。

收到P1的请求之后,P0和P2要发送确认消息给P1表示自己收到了。注意,由于目前请求队列里面第一个不是P1发出的请求,所以此时锁仍属于P0。但是由于收到了确认消息,此时P1已经满足了获取资源的第一个条件:P1已经收到了其他所有进程时间戳大于1的消息。

假设P0此时释放了锁(这里为了方便演示做了这个假设,实际上P0什么时候释放资源都可以,算法都是正确的,读者可自行推导),发送释放资源的消息给P1和P2,P1和P2收到消息之后把请求(0:0)从队列里面删除。

当P0释放了资源之后,我们发现P1满足了获取资源的两个条件:它的请求在队列最前面;P1已经收到了其他所有进程时间戳大于1的消息。也就是说此时P1就获取到了锁。这个算法并不是容错的,有一个进程挂了整个系统就挂了,因为需要等待所有其他进程的响应,同时对网络的要求也很高。
时钟条件与两条实现规则
上文的「C(a) < C(b) 是 a -> b 的必要不充分条件」,写成 Clock Condition:
对任意事件 a、b:若 a -> b,则 C(a) < C(b)。
反向不能成立,理由是:如果 C(a) < C(b) 也蕴含 a -> b,那等价于要求任何两个并发事件必须有相同的时钟值。图 1 里 p2、p3 都与 q3 并发,这就会要求 p2 与 p3 同时发生,而 p2 -> p3 又要求 C(p2) < C(p3),矛盾。
时钟条件可以拆成两条更弱、更好实现的条件,满足它们就自动满足时钟条件:
- C1:若 a、b 是同一进程
上的事件且 a 先发生,则 ; - C2:若 a 是进程
发送消息的事件、b 是 接收该消息的事件,则 。
对应的实现规则:
- IR1:每个进程
在任意两个相邻事件之间递增 。 - IR2:(a) 发送消息 m 时把
带上;(b) 接收消息 m 的进程把 置为不小于当前值且大于 。注意接收事件发生在设置 之后 —— 这只是记号上的细节,实现上没有差别。
把时钟画进时空图可以看出这两条的几何含义:把每个进程的时钟取值想成"滴答",在不同进程上编号相同的滴答之间连一条虚线(称 tick line)。C1 的含义是任意两个事件之间必有一条 tick line,C2 的含义是每条消息线必须穿过一条 tick line。tick line 随后可以当作时空坐标系的坐标线 —— 不引入物理时间的概念,就无法判断哪一组坐标线"更好"。这也是后面必须引入物理时钟的动机。
把两个进程的时空图摊开看(每一列是一个"滴答"编号):
   P1  ──●1──────●2──────●3──────●4──     ● = 事件,数字是 C 的取值
        │       │       │       │
        │       │       │       │          │ = tick line:两个进程上编号相同的
        │       │       │       │              滴答连成的虚线
   P2  ──●1──────●2──────●3──────●4──

   C1:同一进程上任意两个事件之间必有一条 tick line
   C2:每条消息线必须穿过至少一条 tick line
       —— 消息把发送方的时钟值带过去,接收方的时钟至少要跨过一格才盖得住它

   tick line 之后可以直接当坐标线用;但"哪一组坐标线更好"这个问题,
   只靠逻辑时钟答不了 —— 物理时钟的动机就在这里。
全序不唯一:偏序才是唯一被确定的
用时钟给全部事件排序的写法是:a 在 a => b 当且仅当
;或 且 (进程编号用来打破平局)。
这定义了一个全序,并且由时钟条件可知 a -> b 蕴含 a => b —— 也就是它把 happen-before 这个偏序补成了全序。
紧接着有一条容易被忽略的性质:这个全序依赖所选的时钟系统,并不唯一。 不同的、同样满足时钟条件的时钟会给出不同的 => 关系;反过来,给定任何一个扩展了 -> 的全序,都存在一个满足时钟条件的时钟系统生成它。唯一被事件系统确定下来的,只有偏序本身。
这条判据在工程上的读法是:全序是加进去的,不是系统里本来就有的。两个副本对同一组并发事件排出不同的顺序,不代表谁错了。
异常行为与强时钟条件
按上面的全序调度资源,会出现 异常行为(anomalous behavior)。一个例子:一个人先对计算机 A 发出请求 A,然后打电话让另一个城市的朋友对计算机 B 发出请求 B。请求 B 完全可能拿到更小的时间戳、被排在请求 A 之前。
原因是「A 先于 B」这件事发生在系统之外(电话),逻辑时钟看不到。形式化是:设
两种规避方式:
- 把顺序信息显式传进系统:发 A 的人从系统拿到 A 的时间戳
,发 B 时指定 B 的时间戳必须大于 。这个办法把责任交给了使用者。 - 让时钟满足强时钟条件:
Strong Clock Condition:对
中任意事件 a、b,若 则 。
它比普通时钟条件强,因为 -> 包含更多关系的关系。逻辑时钟一般不满足它。 随后把 -> 与狭义相对论的偏序对齐,指出物理时钟可以在彼此独立运行的前提下满足强时钟条件 —— 这是分布式系统要用物理时钟(NTP 与 PTP)的根本理由。
物理时钟:两条约束与推导
引入物理时间坐标后,
两条物理时钟条件
PC1:存在常数
,使对所有 有 PC2:存在足够小的常数
,使对所有 有
PC1 要求时钟走时速率接近正确(量级是:典型晶振控制的时钟
两条时钟永远不会以完全相同的速率走,所以会越飘越远 —— 必须有算法保证 PC2 始终成立。但在此之前要先知道
反推
要避免异常行为,就是要让系统相关的物理事件满足强时钟条件。假设时钟已满足普通时钟条件,那么只需考虑不同进程之间的事件。
设
要避免异常行为,必须保证对任意
推导(完整的一步):重置时钟时只能向前拨、不能向后拨(向后拨会违反 C1)。配合 PC1 可推出
再用 PC2 把
结论:PC1 + PC2 + 上面这条不等式,三者合起来就保证了异常行为不可能发生。这条式子的实用形态是 —— 时钟精度
时钟同步算法
设消息 m 在物理时刻 t 发出、时刻
接收进程当然不知道
称为这条消息的不可预测时延。有了这个量,就把 IR1 / IR2 特化成物理时钟版本:
IR1′:对每个
,若 在物理时刻 t 没有收到消息,则 在 t 处可微且 。 IR2′:(a) 若
在物理时刻 t 发送消息 m,则 m 携带时间戳 ;(b) 在时刻 收到 m 时,把 置为
这两条是前面 IR1 / IR2 的特化,所以仍然满足时钟条件。几点值得注意:
- IR2′ 的结构与 IR2 完全同形,差别只在于加上了已知的最小延迟
—— 因为接收方知道消息至少走了 ,所以对方时钟至少已经是 。 - 它只把时钟向前拨(取
),与上面"重置只能向前"的要求一致。 - 形式化里用了物理时间参数,但进程实现时只需要知道自己的时钟读数与收到消息的时间戳 —— 这几条规则可以直接落地。
- 唯一实现上的实际关切是:离散的时钟 tick 要足够密,以保证 C1 成立。
这个同步算法可以满足 PC2(假设进程系统用一个有向图描述,消息在图上传播)。把时钟精度、同步间隔与网络时延三者串起来的完整协议是后来的 NTP(见 从物理时钟到 NTP 与 PTP 协议)。
结论值得和前面几节对着看:只用逻辑时钟不会有性能损失,只有需要强时钟条件的场景才必须引入物理时钟。
为什么需要向量时钟
首先我们来回顾一下上面讲过的 Lamport 逻辑时钟算法,它提供了一种判断分布式系统中事件全序关系的方法:如果 a -> b,那么 C(a) < C(b),但是 C(a) < C(b) 并不能说明 a -> b。也就是说C(a) < C(b) 是 a -> b 的必要不充分条件,我们不能通过 Lamport 时间戳对事件 a、b 的因果关系进行判断。**下面我们举一个例子来说明。

假设有三个进程在发消息,Ts(mi)表示消息mi的发送时间戳,Tr(mi)表示消息mi的接受时间戳,显然 Ts(mi) < Tr(mi),但是这个能说明什么呢?
我们可以发现在进程 P2 中,Tr(m1) < Ts(m3),说明 m3 是在 m1 被接收之后发送的,也就是说 m3 的发送跟 m1 的接收有关系。难道通过 Lamport 时间戳就能区分事件的因果的关系了吗?答案是 No,我们仔细看可以发现,虽然 Tr(m1) < Ts(m2),但实际上 m2 的发送跟 m1 并没有关系。
可以发现 Lamport 逻辑时钟算法中每个进程只拥有自己的本地时间,没有其他进程的时间,导致无法描述事件的因果关系。如果每个进程都能够知道其他所有进程的时间,是否就能够得到事件的因果关系了呢?为此,有人提出了向量时钟算法,在 Lamport 逻辑时钟的基础上进行了改良,提出了一种在分布式系统中描述事件因果关系的算法。
可能有人会有疑问:向量时钟到底有什么用呢?举一个常见的工程应用:数据冲突检测。分布式系统中数据一般存在多个副本,多个副本可能被同时更新,这会引起副本间数据不一致,此时冲突检测就非常重要。**基于向量时钟我们可以获得任意两个事件的顺序关系,结果要么是有因果关系(先后顺序),要么是没有因果关系(同时发生)。通过向量时钟,我们能够识别到如果两个数据更新操作是同时发生的关系,那么说明出现了数据冲突。后面我们会详细说明相关的实现。
什么是向量时钟
通过上面的分析我们知道向量时钟算法是**在 Lamport 逻辑时钟的基础上进行了改良,用于在分布式系统中描述事件因果关系的算法。**那么为什么叫向量时钟呢?前面我们知道如果每个进程都能够知道其他所有进程的时间,就能够通过计算得到事件的因果关系。向量时钟算法利用了向量这种数据结构将全局各个进程的逻辑时间戳广播给各个进程:每个进程发送事件时都会将当前进程已知的所有进程时间写入到一个向量中,附带在消息中。这就是向量时钟命名的由来。
如何实现向量时钟
假设分布式系统中有 N 个进程,每个进程都有一个本地的向量时间戳 Ti,向量时钟算法实现如下:
对于进程 i 来说,Tii 是进程 i 本地的逻辑时间 当进程 i 当有新的事件发生时,Tii = Tii + 1 当进程 i 发送消息时将它的向量时间戳(MT=Ti)附带在消息中。 接受消息的进程 j 更新本地的向量时间戳:Tjk = max(Tjk, MTk) for k = 1 to N。(MT即消息中附带的向量时间戳)
下图是向量时钟的示例:

那么如何利用向量时钟判断事件的因果关系呢?我们知道分布式系统中的事件要么是有因果关系(先后顺序),要么是没有因果关系(同时发生),下面我们来看一下如何利用向量时钟判断时间的因果关系。
假设有事件 a、b 分别在节点 P、Q 上发生,向量时钟分别为 Ta、Tb,如果 TbQ > TaQ 并且 TbP >= TaP,则a发生于b之前,记作 a -> b,此时说明事件 a、b 有因果关系; 反之,如果 TbQ > TaQ 并且 TbP < TaP,则认为a、b同时发生,记作 a <-> b。例如上图中节点 B 上的第 4 个事件 (A:2,B:4,C:1) 与节点 C 上的第 2 个事件 (B:3,C:2) 没有因果关系,属于同时发生事件。
逐分量比较两个向量时钟,结果只有三种:
     Ta = (A:2, B:4, C:1)
     Tb = (A:0, B:3, C:2)
          A: 2>0    B: 4>3    C: 1<2
          └──── 两个方向都有更大的分量 ────┘
          ⇒ a 与 b 并发(a ∥ b)—— 就是前面那个「节点 B 第 4 个事件
             与节点 C 第 2 个事件」的例子

三种结果穷尽:
     Ta 的每个分量都 ≤ Tb,且至少一个严格更小   ⇒ a → b(a 因果先于 b)
     Tb 的每个分量都 ≤ Ta,且至少一个严格更小   ⇒ b → a
     两个方向各有分量更大                        ⇒ a ∥ b(只有这一种情况是并发)
向量时钟的实际应用
前面我们提到向量时钟可以用来检测分布式系统中多副本更新的数据冲突问题,注意是检测(发现问题),它并不能解决问题。数据冲突的解决是另一个课题,这里不展开了。
亚马逊的 Dynamo 是一个分布式Key/Value存储系统,为了高可用,即使在出现网络分区或者机器宕机时依然可读可写。当网络分区恢复之后,多个副本同步数据一定会出现数据不一致的情况,那么如何检测数据冲突呢?参考向量时钟(Vector clock)的思想,Dynamo 中使用了版本向量(Version vector)来检测数据冲突,下面我们来看看算法的实现。

client 端写入数据,该请求被 Sx 处理并创建相应的 vector (Sx, 1),记为数据 D1 第 2 次请求也被 Sx 处理,数据修改为 D2,vector 修改为(Sx, 2) 第 3、4 次请求分别被 Sy、Sz 处理,client 端先读取到 D2,然后 D3、D4 被写入 Sy、Sz 第 5 次更新时 client 端读取到 D2、D3 和 D4 3个数据版本,通过类似向量时钟判断同时发生关系的方法可判断 D3、D4 是同时发生的事件,因此存在数据冲突,最终通过一定方法解决数据冲突并写入 D5
注意,向量时钟和版本向量并不是同一个东西,版本向量借鉴了向量时钟中利用向量来判断事件的因果关系的思想,用于检测数据冲突。向量时钟还有其他的应用,例如强制因果通信(Enforcing Causal Communication)等。
相关
- 04-全局快照与虚拟时间 —— 把本篇「线性化偏序要付信息代价」这一点展开,并给出保留偏序的时钟结构
- 01-全序、偏序 —— 全序与偏序的形式定义
- 05-Interval Tree Clocks —— 把 fork / event / join 抽成因果跟踪机制的公共骨架
- 02-从物理时钟到NTP与PTP协议 —— 本篇「物理时钟」一节只推约束,协议的实现(晶振误差、校时机制)见这篇
参考
- Leslie Lamport. Time, Clocks, and the Ordering of Events in a Distributed System. Communications of the ACM, Vol. 21, No. 7, July 1978, pp. 558–565.
- Giuseppe DeCandia et al. Dynamo: Amazon's Highly Available Key-value Store. SOSP 2007.
 YJ